TypeSafe Jev 출시 — 문장 대신 '승인 82%'로 답하는 AI, LLM과 차이
TypeSafe AI가 공개한 Jev는 문장을 만들지 않고 확률이 붙은 판단만 돌려주는 System One 모델이다. 속도와 비용에서 기존 LLM을 수백 배 앞선다고 주장하지만 집계 정확도는 67.8%로 상위 LLM에 못 미친다. Jev가 어디에 쓸모 있고 어디서 위험한지 짚었다.
솔직히 처음 제목만 봤을 땐 또 하나의 과장 광고인 줄 알았다. "환각이 불가능한 AI"라니, 이 바닥에서 몇 번이나 들어본 문장이다.
생각이 바뀐 건 만든 사람 이름을 보고 나서였다. Diogo Almeida. ChatGPT의 뼈대가 된 InstructGPT 논문의 공동저자이자 전 OpenAI 연구자다. 그가 2년 동안 회사 간판도 내걸지 않고 만든 결과물이 9월 15일 공개됐다. TypeSafe AI의 첫 모델, Jev다.
문장을 만들지 않는 AI
한 문장으로 줄이면 이렇다. 답을 글로 쓰지 않고, 판단만 숫자로 돌려주는 AI.
예를 들어보자. 챗봇에게 "이 환불 요청 승인해도 될까?"라고 물으면 보통 세 문단짜리 설명이 돌아온다. 고객의 구매 이력이 어떻고, 정책상 어떤 조항이 적용되고, 따라서 승인하는 것이 합리적으로 보인다는 식으로.
Jev는 이렇게 답한다.
승인: 82%
그게 전부다. 설명도, 서론도, 양해를 구하는 문장도 없다.
차이는 답을 만드는 방식에서 온다. 지금의 챗봇들은 글자를 하나씩 순서대로 뱉는다. 앞에 쓴 글자를 보고 다음 글자를 고르는 구조라 답이 길어질수록 시간도 비례해 늘어난다. Jev는 정해진 보기 중 하나를 골라 확신도를 붙인 뒤 한 번에 내놓는다. 쓸 문장이 없으니 길이라는 개념 자체가 없다.
학습 방식도 갈라진다. 기존 모델들이 "사람이 더 좋아할 만한 답"을 향해 훈련된다면, Jev는 RLCD라는 방법으로 "확률이 정확하게 들어맞는 판단"을 향해 훈련됐다고 한다. 잘 쓴 문장이 아니라 잘 맞은 숫자가 목표인 셈이다.
회사는 이걸 "프런티어급 지능을 가진 함수 호출"이라고 표현했다. 정리되지 않은 상황을 넣으면 형식이 정해진 판단이 나온다는 뜻이다.
이름도 여기서 나왔다. 대니얼 카너먼이 말한 직관적 사고, 시스템 1이다. 곱씹어 추론하는 대신 즉각 판단하는 쪽을 골랐다는 선언에 가깝다.
예시 하나로 보면 확실해진다
고객센터에 이런 문의가 들어왔다고 하자.
"결제했는데 돈은 빠져나갔는데 상품이 안 왔어요."
기존 LLM에게 "이 문의 좀 분류해줘"라고 하면 이렇게 답한다.
결제 오류로 보입니다.
읽기엔 좋지만 프로그램이 바로 쓰기엔 애매하다. 저 문장을 다시 뜯어서 "그래서 어느 팀으로 보내라는 거지?"를 코드가 한 번 더 해석해야 한다.
같은 문의를 Jev에게 줄 땐 질문과 보기를 같이 건넨다.
- 입력: "결제했는데 돈은 빠져나갔는데 상품이 안 왔어요."
- 질문: 이 문의의 유형은?
- 보기: 결제 오류 · 배송 오류 · 환불 요청 · 계정 문제
돌아오는 건 문장이 아니라 숫자다.
| 유형 | 확신도 |
|---|---|
| 결제 오류 | 0.82 |
| 배송 오류 | 0.14 |
| 환불 요청 | 0.03 |
| 계정 문제 | 0.01 |
그러면 프로그램은 이 숫자를 그대로 받아 이렇게 쓴다.
if result.confidence > 0.8:
    route_to_payment_team()   # 확신도 높으면 결제팀으로 자동 배정
else:
    send_to_human()           # 애매하면 사람에게 넘김
문장을 다시 해석하는 단계가 통째로 빠진다. "소프트웨어가 바로 갖다 쓰는 판단"이라는 말이 실제로는 이런 모습이다.
속도와 가격이 진짜 이야기다
이 모델의 핵심은 똑똑함이 아니다. 숫자를 나란히 놓으면 분명해진다.
| 기존 LLM | Jev | |
|---|---|---|
| 응답 시간 | 3초 ~ 329초 | 70 ~ 500밀리초 |
| 생성 방식 | 토큰 하나씩 순차 | 한 번에 병렬 |
| 출력 형태 | 문장(파싱·검증 필요) | 형식이 정해진 값 |
| 확신도 | 물어봐도 과신하거나 들쭉날쭉 | 매 출력마다 보정된 확률 |
| 출력 비용 | 입력의 약 5배 | 무료 |
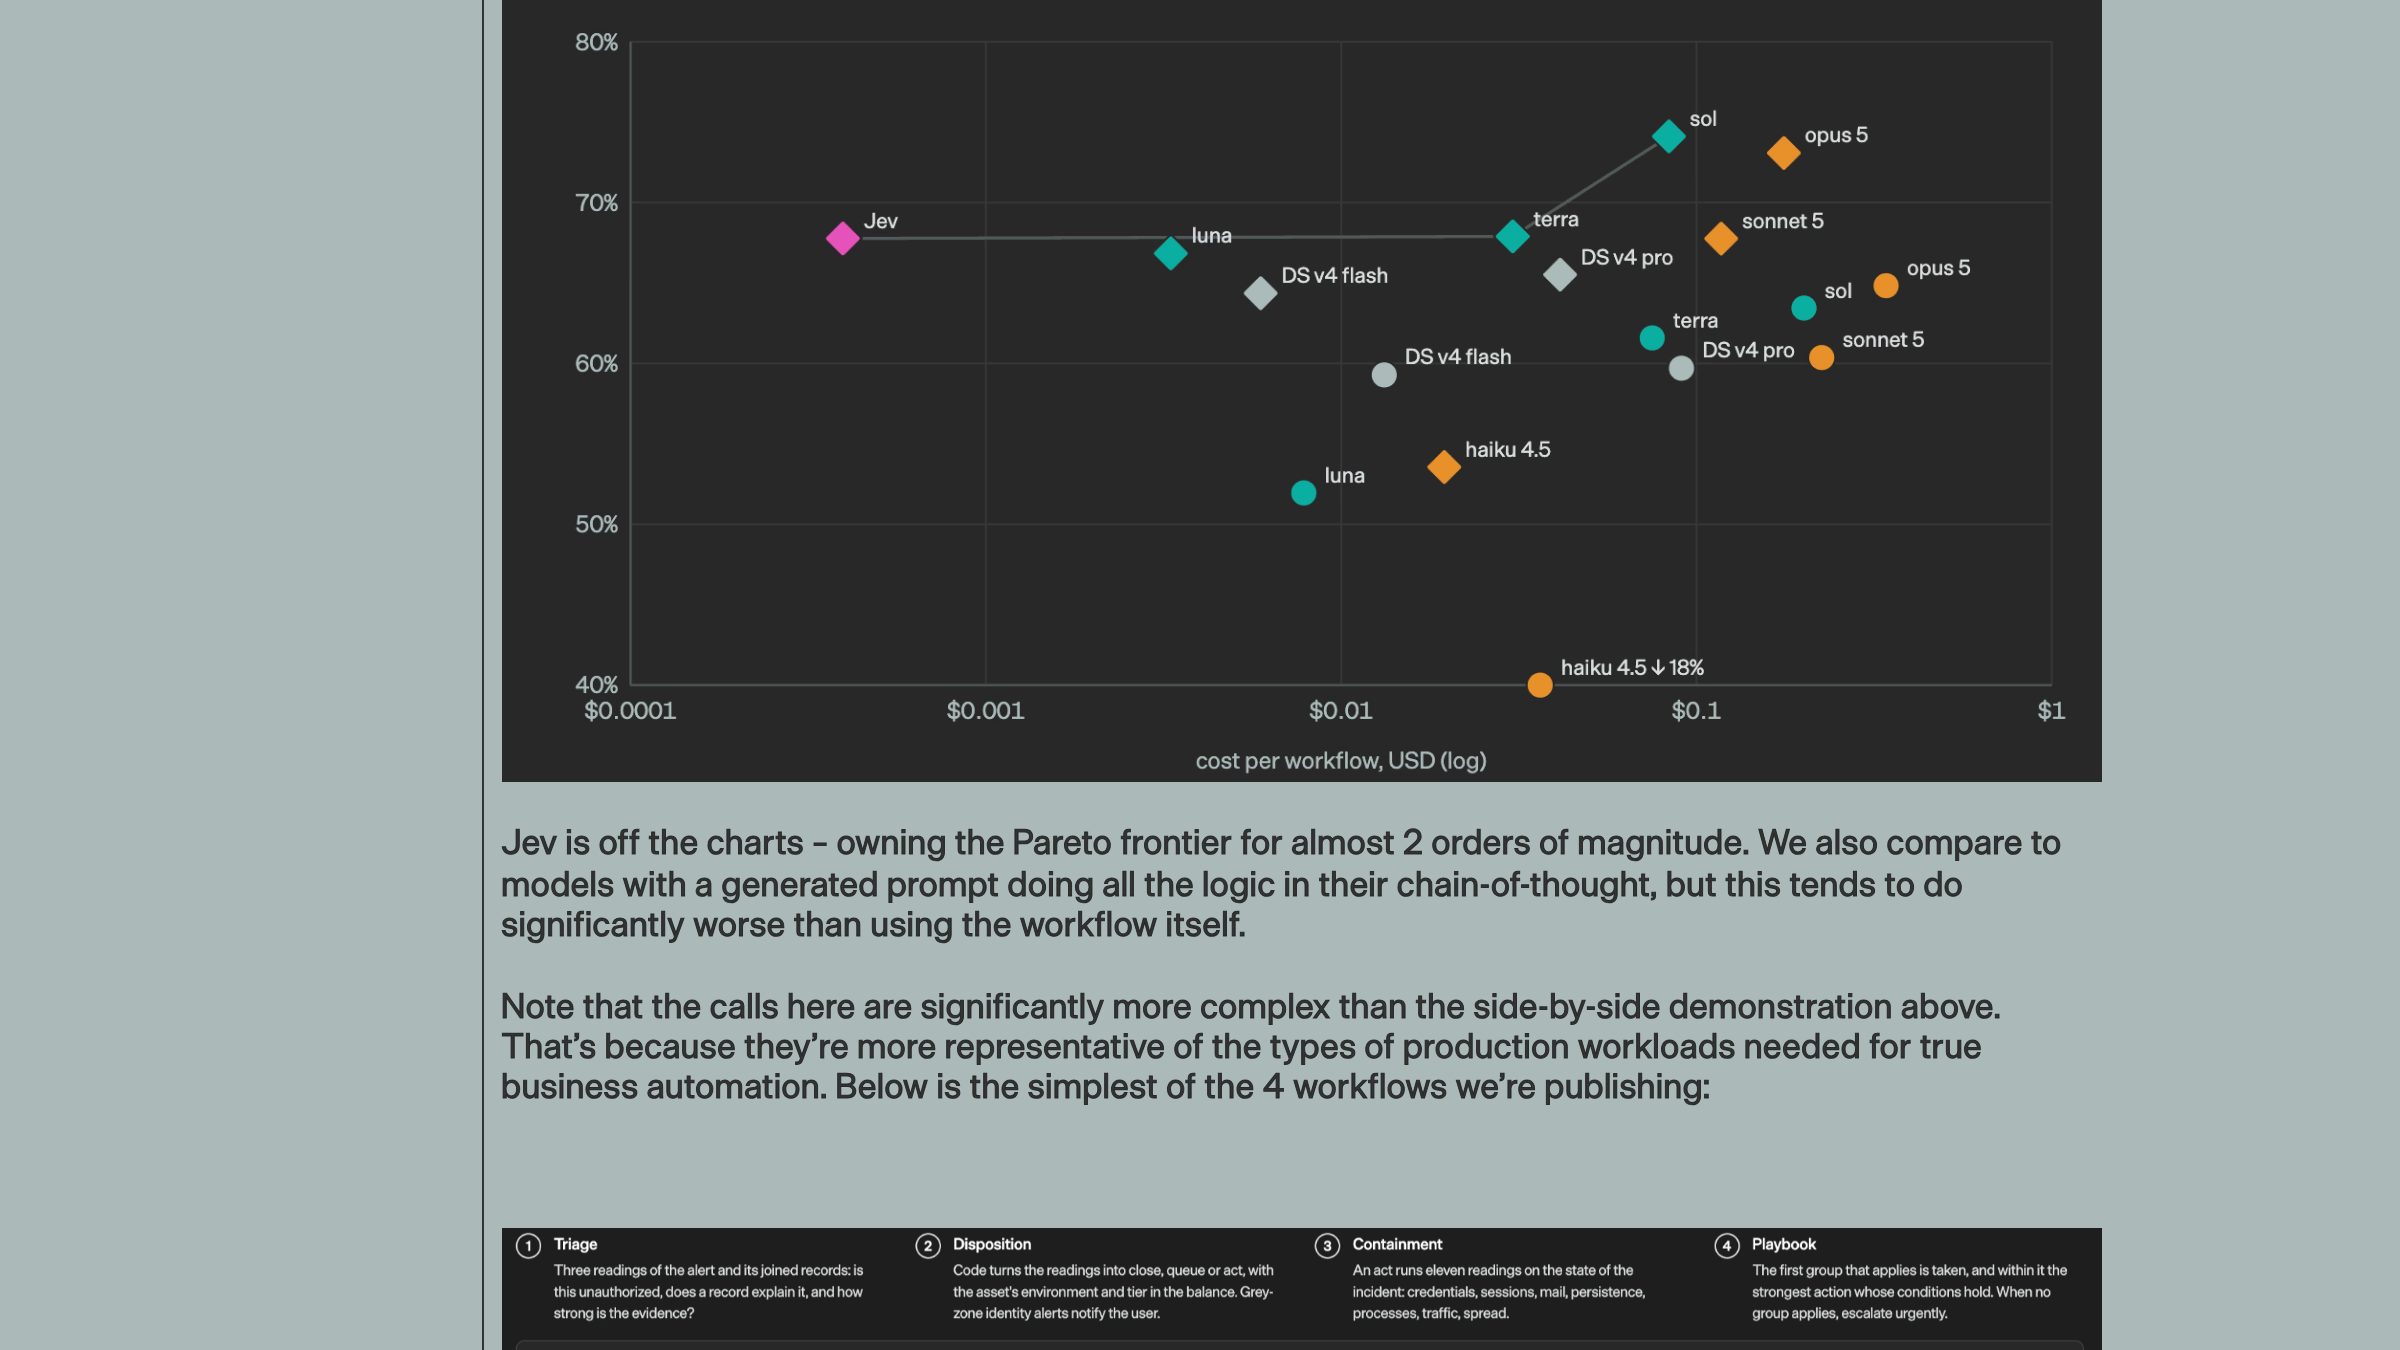
회사가 자체 설계한 워크플로 평가에서는 최대 193.6배 빠르고 444.6배 저렴하다는 수치가 나왔다. 입력은 10억 토큰에 42달러, 출력은 "과금하기엔 너무 저렴하다"며 아예 받지 않는다.
눈에 띄는 건 회사 스스로 "이건 실제 이득의 상한선에 가까울 것"이라고 단서를 달았다는 점이다. 벤더가 자기 벤치마크에 이런 문장을 붙이는 경우는 흔치 않다.
그래서 어디에 쓰는 물건인가
개발자들이 "퍼지 if문"이라고 부르는 자리가 있다. 조건문으로 딱 떨어지지 않아 사람이 눈으로 봐야 했던 판단들이다.
- 들어온 고객 문의를 어느 팀으로 보낼지 고르는 분류와 라우팅
- 문서 더미에서 필요한 항목만 뽑아내는 추출
- 위험도나 우선순위처럼 점수를 매기는 일
- 다른 AI가 내놓은 답이 정책을 벗어나지 않았는지 검사하는 가드레일
응답이 100밀리초대라는 점도 크다. 화면이 멈추지 않으니, 사용자가 기다리고 있는 자리에도 AI 판단을 끼워 넣을 수 있다는 뜻이다.
회사가 공개한 데모가 이 성격을 잘 보여준다. 텍스트로 바꾼 게임 화면을 초당 열 번씩 읽으며 둠(Doom)을 실시간으로 플레이하는데, 한 시간에 드는 비용이 7달러다. 위키백과 링크만 따라가 목표 문서에 도달하는 위키레이싱에서는 선택지 255개를 한 번에 놓고 고른다. 지금은 얼리액세스라 콘솔에서 따로 신청해야 쓸 수 있다.
"환각이 불가능하다"는 말의 함정
여기서부터가 논란이다.
형식이 깨진 답, 그러니까 JSON이 망가지거나 없는 항목이 튀어나오는 일은 구조상 일어날 수 없다. 이건 사실이다. 문제는 그다음이다.
정해진 보기 중에서 확신에 차서 틀린 답을 고르는 것은 여전히 가능하다. 형식이 멀쩡하다는 것과 판단이 옳다는 것은 전혀 다른 얘기다. 소프트웨어 엔지니어 Sean Goedecke는 "환각을 못 한다"는 표현이 환각의 정의를 좁게 잡아 피해간 쪽에 가깝다고 지적했다. 그는 일반 LLM도 답의 앞부분을 미리 채워 넣고 제한된 토큰 하나만 뽑게 하면 속도 이득의 상당 부분을 이미 얻을 수 있다고 덧붙였다.
정확도 숫자는 더 직설적이다. 공개된 벤치마크에서 Jev의 집계 정확도는 67.8%. 비교 대상인 Sol은 74.1%였다. 인보이스 처리처럼 실무에 가까운 과제에서는 61.8% 대 79.1%로 격차가 더 벌어진다. 빠르고 싸지만 똑똑함에서는 최상위 모델에 못 미친다는 맞교환이 수치로 드러난 셈이다.
더 근본적인 지적은 채점 방식에 있다. 이 평가의 "정답"은 사람이 검증한 값이 아니라 GPT-6 Astra, Claude Fable 5.1 같은 최상위 모델들의 답을 평균 낸 것이다. 제일 똑똑한 AI들의 평균과 비슷하게 답하면 잘한 것으로 치는 구조다. 확신도 보정의 근거가 되는 곡선은 공개되지 않았고, 모델 크기와 학습 데이터 출처도 비공개다. 공개 직후에는 'OpenJev'라는 오픈소스 클론을 둘러싼 이름 분쟁까지 붙었다.
국내 서비스에 대입해보면 쓸모가 선명해지는 자리가 있다. 고객센터에 하루 수천 건씩 쌓이는 문의를 1차로 분류하는 일, 결제 로그에서 이상거래 후보를 골라내는 일, 커뮤니티에 올라온 글이 운영정책에 걸리는지 훑는 일. 공통점은 판단이 반복되고, 양이 많고, 틀려도 다음 단계에서 사람이 잡아줄 수 있다는 것이다.
이런 자리에서는 정확도 67.8%도 충분히 값어치를 한다. 사람이 전부 보던 걸 20%만 보게 만들어주면 그것만으로 이득이기 때문이다.
반대로 위험한 자리도 분명하다. 확신도 숫자가 붙는다는 점이 오히려 함정이 될 수 있다고 본다. "승인 82%"라는 표기에는 검토를 건너뛰게 만드는 힘이 있다. 숫자가 붙으면 이미 검증된 것처럼 느껴지기 때문이다. 상위 모델보다 정확도가 낮은 쪽이 더 자신 있어 보이는 형태로 답한다는 건 운영하는 입장에서 꽤 신경 쓰이는 조합이다.
도입을 검토한다면 벤더 벤치마크는 참고만 하고, 자사 데이터 수백 건에 사람이 직접 라벨을 붙여 다시 재보는 게 먼저다. 그리고 진짜 설계 포인트는 모델이 아니라 임계값이다. 몇 퍼센트부터 자동으로 처리하고 몇 퍼센트부터 사람에게 넘길지, 그 경계선을 어디에 긋느냐가 서비스 품질을 갈라놓는다. 갖다 붙이면 끝나는 물건은 아니라는 얘기다.
결국 무엇을 사는 건가
Jev는 더 똑똑한 AI가 아니라 더 싸고 빠른 판단기다. 문장을 포기한 대가로 속도와 가격을 얻었고, 정확도는 최상위 모델에 못 미친다. 챗봇을 대체하는 물건이 아니라, 지금까지 AI를 쓰기엔 너무 비싸고 느렸던 자리를 메우는 쪽에 가깝다.
이름을 빌려온 제번스의 역설처럼, 판단 한 건의 값이 싸지면 사람들은 판단을 훨씬 더 많이 쓰게 된다. 그게 이 회사가 건 베팅이다.
여러분의 서비스에는 "사람이 눈으로 보고 넘기던 판단"이 어디에 있나요? 그 자리에 82%짜리 자동 판단을 넣는다면, 몇 퍼센트부터 믿고 맡기시겠습니까?
📎 출처: 원문 보기
- typesafe.aihttps://typesafe.ai/blog/introducing-system-one-models-and-jev
댓글 0
댓글을 불러오는 중…